排序算法

内容纲要
排序算法
算法动图详解:https://visualgo.net/zh/sorting
伪代码来源:https://www.tutorialspoint.com/data_structures_algorithms
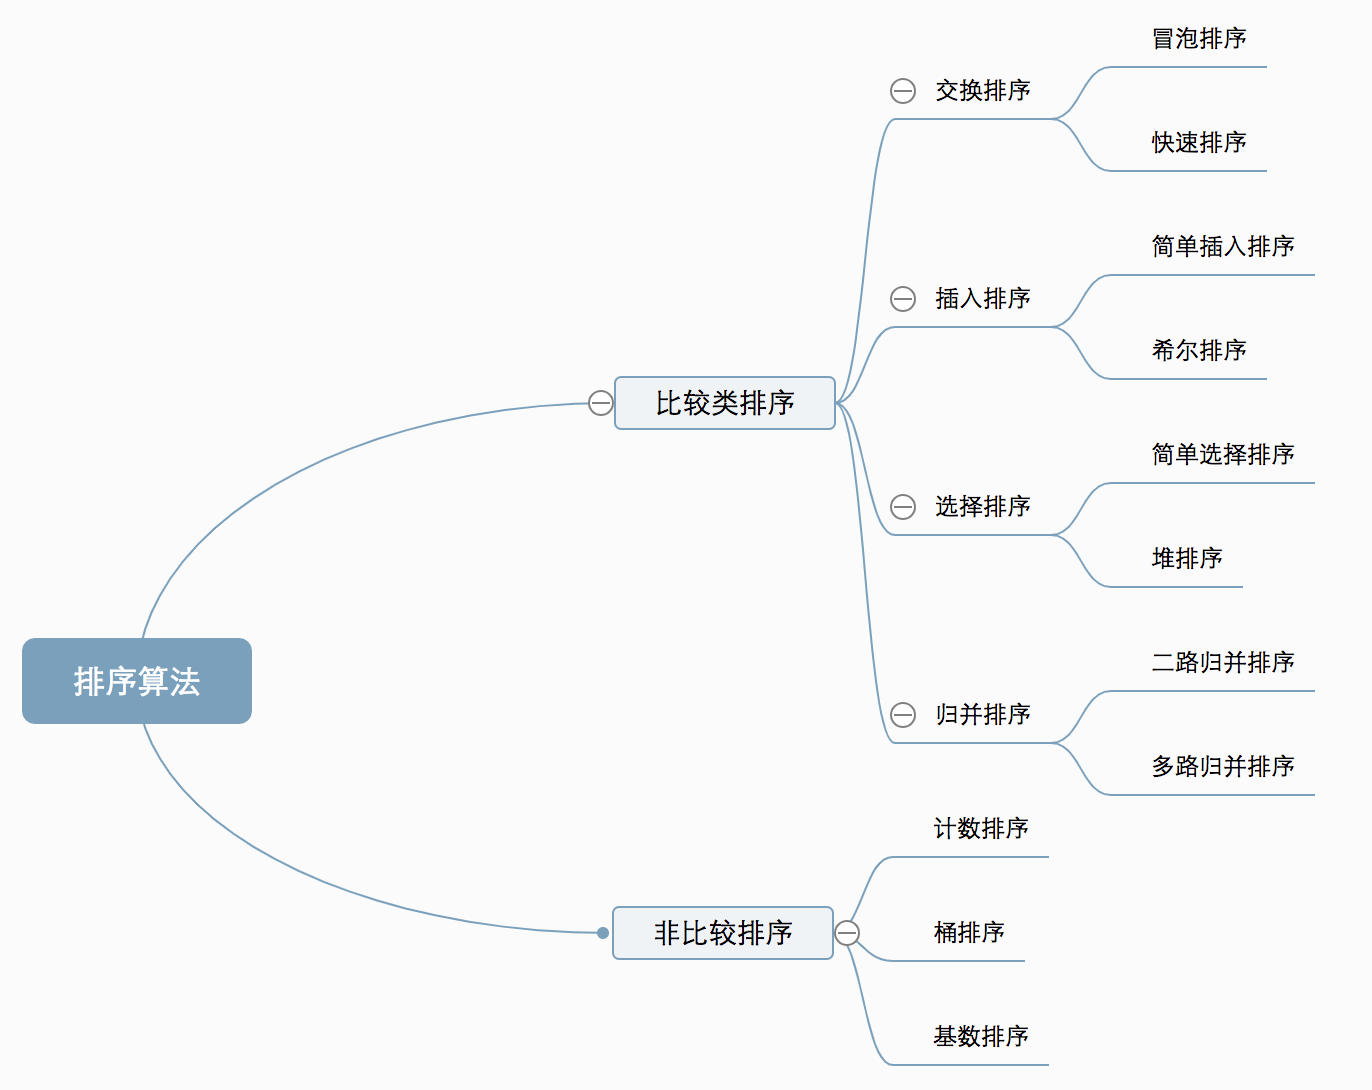
算法分类
比较类排序:
通过比较来决定元素间的相对次序,由于其时间复杂度不能突破O(nlogn),因此也称为非线性时间比较类排序。
非比较类排序:
不通过比较来决定元素间的相对次序,它可以突破基于比较排序的时间下界,以线性时间运行,因此也称为线性时间非比较类排序。
算法复杂度
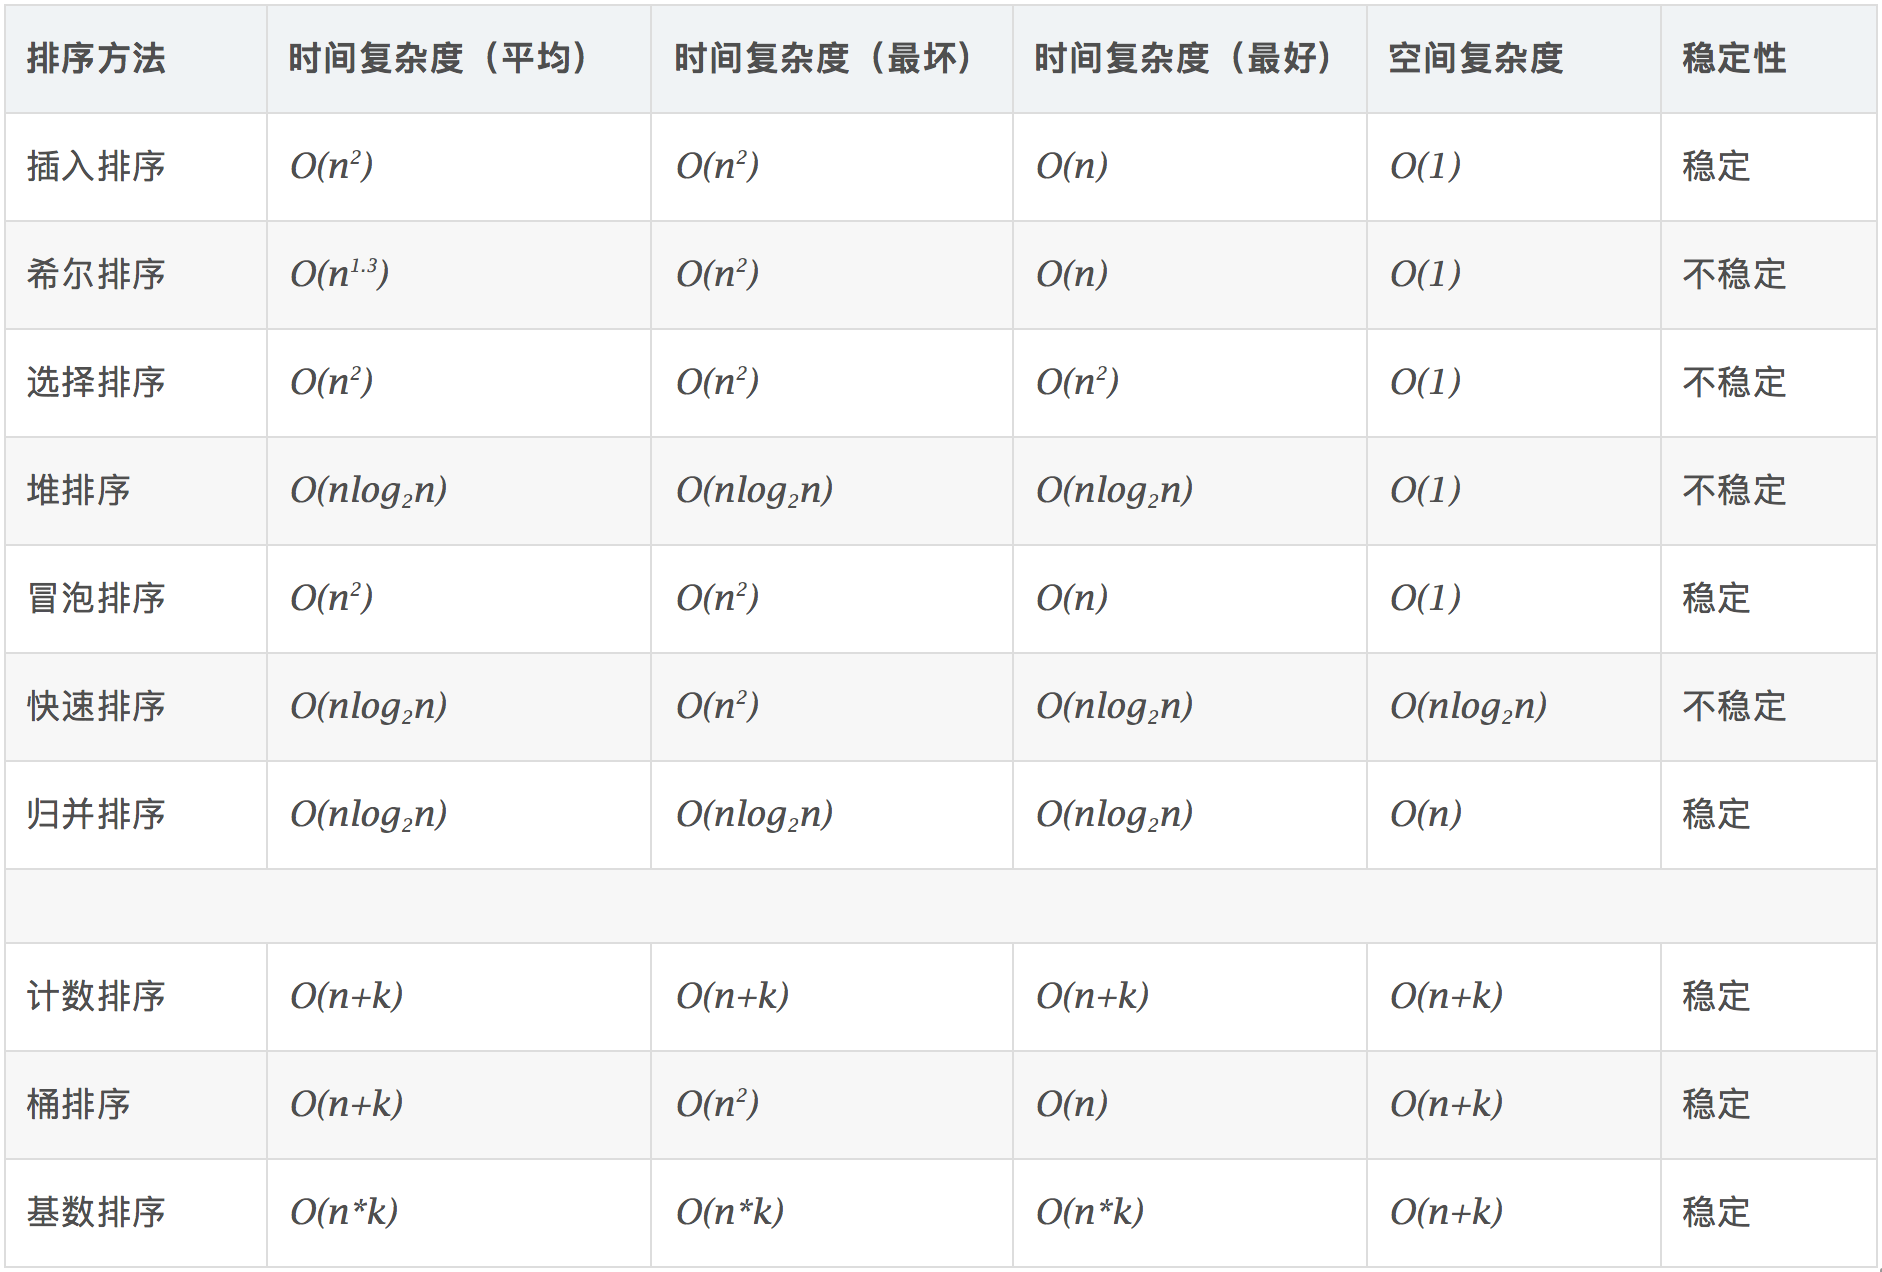
相关概念
稳定:如果a原本在b前面,而a=b,排序之后a仍然在b的前面。
不稳定:如果a原本在b的前面,而a=b,排序之后 a 可能会出现在 b 的后面。
时间复杂度:对排序数据的总的操作次数。反映当n变化时,操作次数呈现什么规律。
空间复杂度:是指算法在计算机内执行时所需存储空间的度量,它也是数据规模n的函数。
冒泡排序(Bubble Sort)
冒泡排序是一种简单的排序算法。它重复地走访过要排序的数列,一次比较两个元素,如果它们的顺序错误就把它们交换过来。走访数列的工作是重复地进行直到没有再需要交换,也就是说该数列已经排序完成。这个算法的名字由来是因为越小的元素会经由交换慢慢“浮”到数列的顶端。
算法描述
- 比较相邻的元素。如果第一个比第二个大,就交换它们两个;
- 对每一对相邻元素作同样的工作,从开始第一对到结尾的最后一对,这样在最后的元素应该会是最大的数;
- 针对所有的元素重复以上的步骤,除了最后一个;
- 重复步骤1~3,直到排序完成。
动图演示
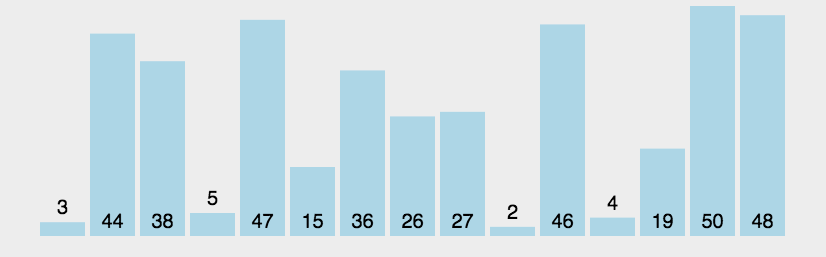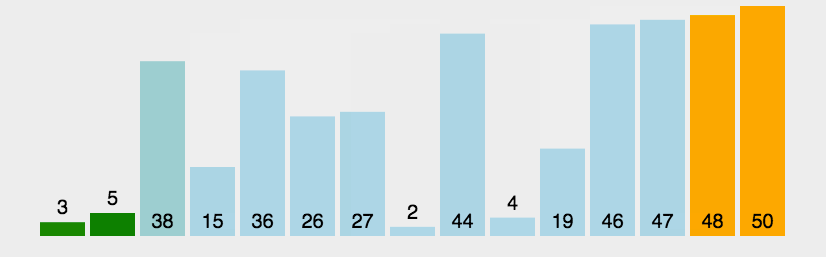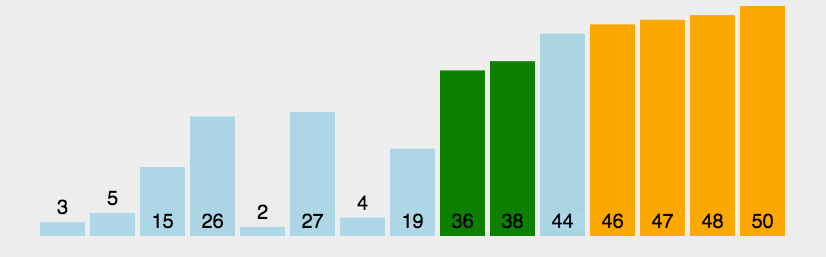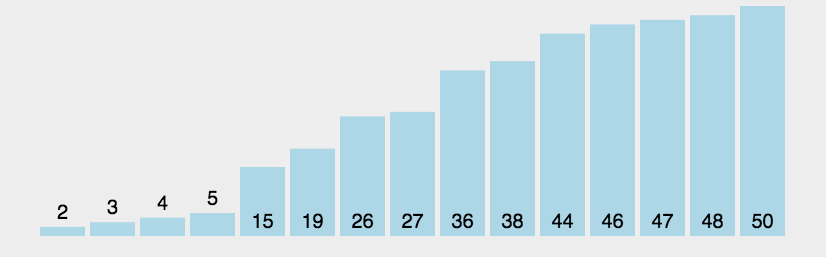
代码实现
#include <iostream>
using namespace std;
int main() {
    int a[] = {10, 9, 8, 7, 6, 5, 4, 3, 2, 1};
    int len = (int)sizeof(a) / sizeof(*a);

    for(int i = 0; i < len - 1; i++) {
        for(int j = 0; j < len - 1 - i; j++) {
            if(a[j] > a[j + 1]) {
                swap(a[j], a[j + 1]);
            }
        }
    }

    for(int i = 0; i < len; i++) {
        cout << a[i] << ' ';
    }

    return 0;
}
选择排序(Selection Sort)
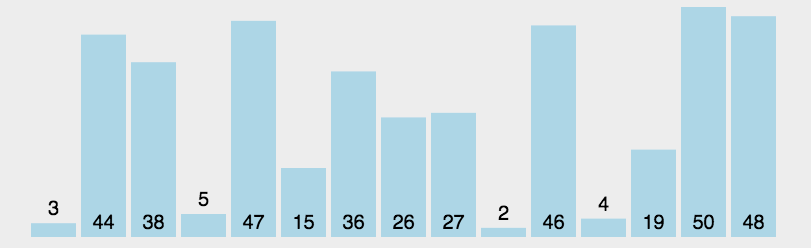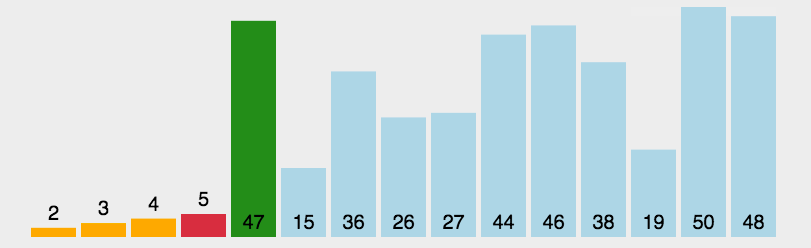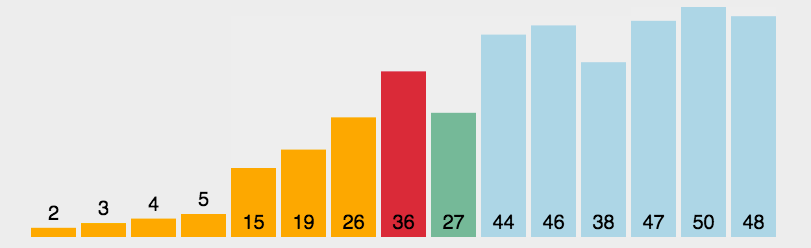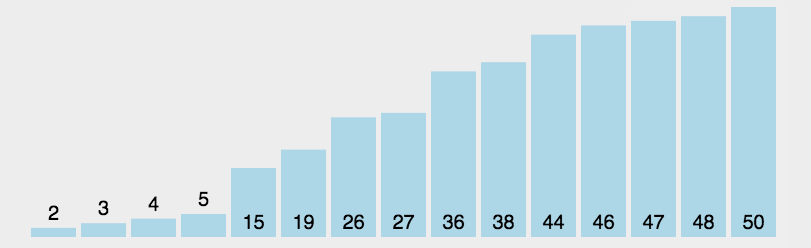
选择排序(Selection-sort)是一种简单直观的排序算法。它的工作原理:首先在未排序序列中找到最小(大)元素,存放到排序序列的起始位置,然后,再从剩余未排序元素中继续寻找最小(大)元素,然后放到已排序序列的末尾。以此类推,直到所有元素均排序完毕。
算法描述
n个记录的直接选择排序可经过n-1趟直接选择排序得到有序结果。具体算法描述如下:
- 初始状态:无序区为R[1..n],有序区为空;
- 第i趟排序(i=1,2,3…n-1)开始时,当前有序区和无序区分别为R[1..i-1]和R(i..n)。该趟排序从当前无序区中-选出关键字最小的记录 R[k],将它与无序区的第1个记录R交换,使R[1..i]和R[i+1..n)分别变为记录个数增加1个的新有序区和记录个数减少1个的新无序区;
- n-1趟结束,数组有序化了。
动图演示
代码实现
#include <iostream>
using namespace std;
int main() {
    int a[] = {10, 9, 8, 7, 6, 5, 4, 3, 2, 1};
    int len = (int)sizeof(a) / sizeof(*a);
    int min;

    for(int i = 0; i < len - 1; i++) {
        min = i;

        for(int j = i + 1; j < len; j++) {
            if(a[j] < a[min]) {
                min = j;
            }
        }

        swap(a[i], a[min]);
    }

    for(int i = 0; i < len; i++) {
        cout << a[i] << ' ';
    }

    return 0;
}
插入排序(Insertion Sort)
插入排序(Insertion-Sort)的算法描述是一种简单直观的排序算法。它的工作原理是通过构建有序序列,对于未排序数据,在已排序序列中从后向前扫描,找到相应位置并插入。
算法描述
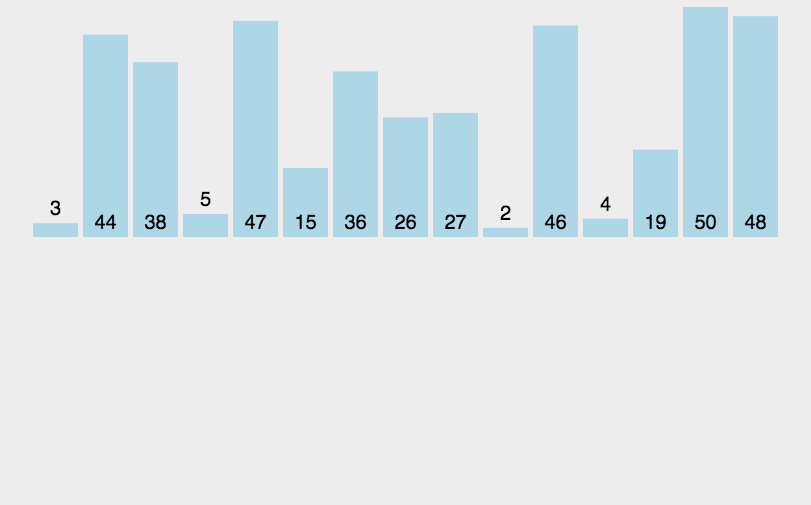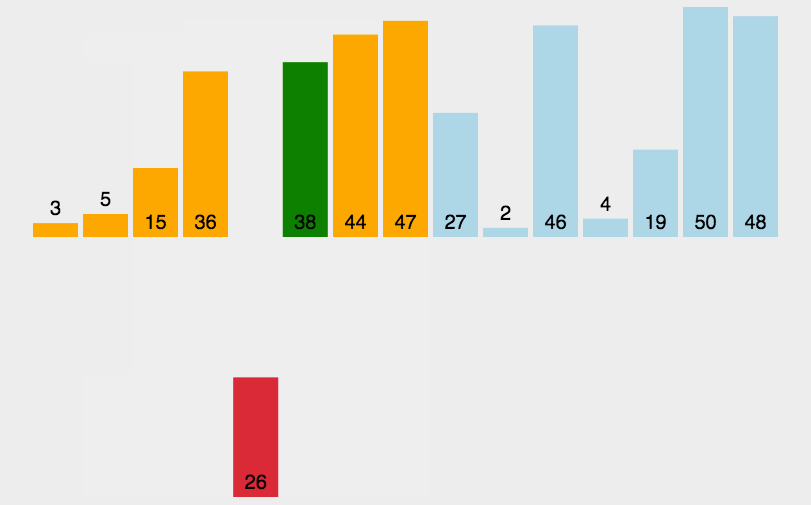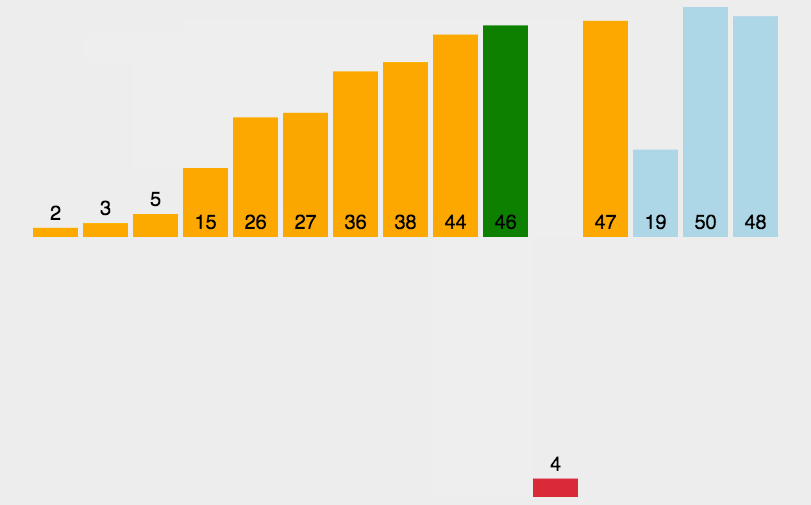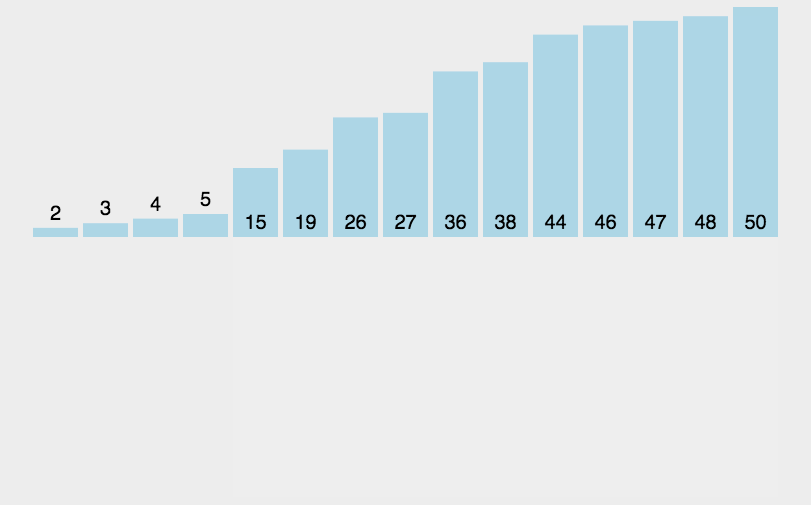
一般来说,插入排序都采用in-place在数组上实现。具体算法描述如下:
- 从第一个元素开始,该元素可以认为已经被排序;
- 取出下一个元素,在已经排序的元素序列中从后向前扫描;
- 如果该元素(已排序)大于新元素,将该元素移到下一位置;
- 重复步骤3,直到找到已排序的元素小于或者等于新元素的位置;
- 将新元素插入到该位置后;
- 重复步骤2~5。
动图演示
代码实现
#include <iostream>
using namespace std;
int main() {
    int a[] = {10, 9, 8, 7, 6, 5, 4, 3, 2, 1};
    int len = (int)sizeof(a) / sizeof(*a);
    int pre, cur;

    for(int i = 1; i < len; i++) {
        pre = i - 1;
        cur = a[i];

        while(pre >= 0 && a[pre] > cur) {
            a[pre + 1] = a[pre];
            pre--;
        }

        a[pre + 1] = cur;
    }

    for(int i = 0; i < len; i++) {
        cout << a[i] << ' ';
    }

    return 0;
}
希尔排序(Shell Sort)
1959年Shell发明,第一个突破O(n2)的排序算法,是简单插入排序的改进版。它与插入排序的不同之处在于,它会优先比较距离较远的元素。希尔排序又叫缩小增量排序。
算法描述
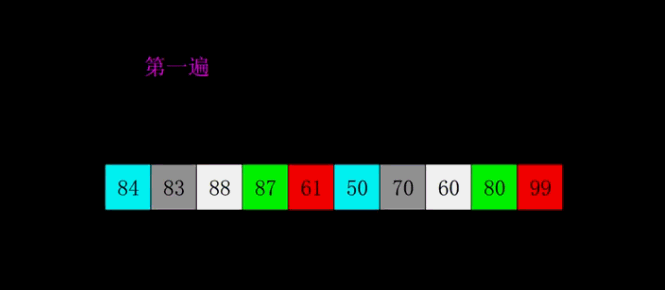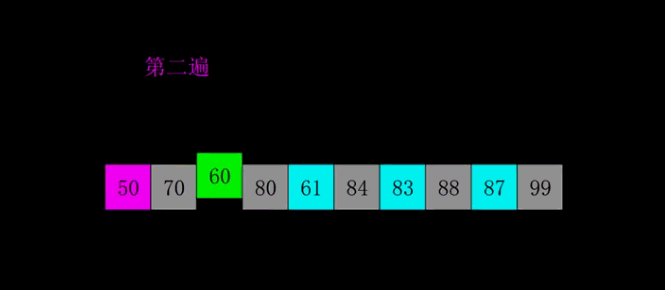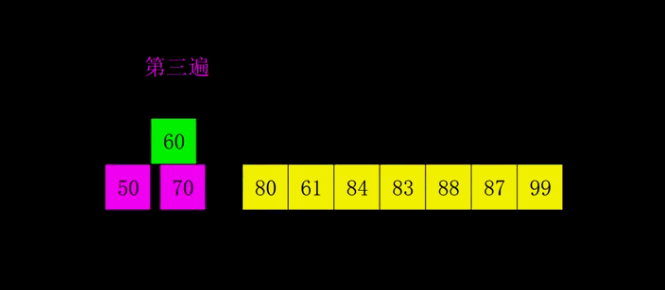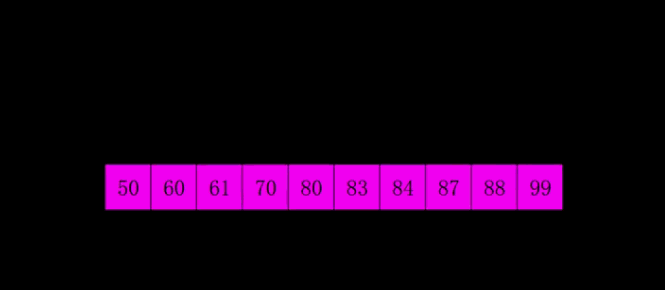
先将整个待排序的记录序列分割成为若干子序列分别进行直接插入排序,具体算法描述:
- 选择一个增量序列t1,t2,…,tk,其中ti>tj,tk=1;
- 按增量序列个数k,对序列进行k 趟排序;
- 每趟排序,根据对应的增量ti,将待排序列分割成若干长度为m 的子序列,分别对各子表进行直接插入排序。仅增量因子为1 时,整个序列作为一个表来处理,表长度即为整个序列的长度。
动图演示
代码实现
#include <iostream>
using namespace std;
int main() {
    int a[] = {10, 9, 8, 7, 6, 5, 4, 3, 2, 1};
    int len = (int)sizeof(a) / sizeof(*a);

    for(int gap = len / 2; gap > 0; gap /= 2) {//遍历所有的步长
        for(int i = gap; i < len; i++) { //遍历所有的元素
            for(int j = i - gap; j >= 0; j -= gap) { //遍历本组中所有元素
                if(a[j] > a[j + gap]) {
                    swap(a[j], a[j + gap]);
                }
            }
        }
    }

    printf("\n");

    for(int i = 0; i < len; i++) {
        cout << a[i] << ' ';
    }

    return 0;
}
归并排序(Merge Sort)
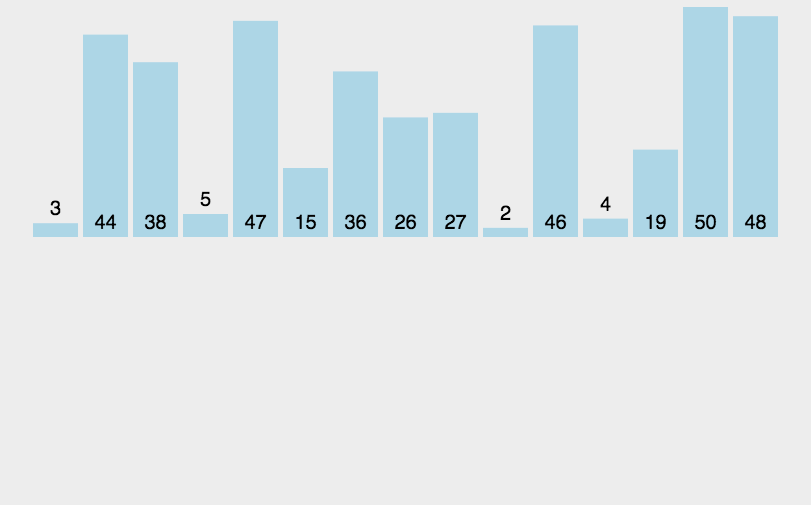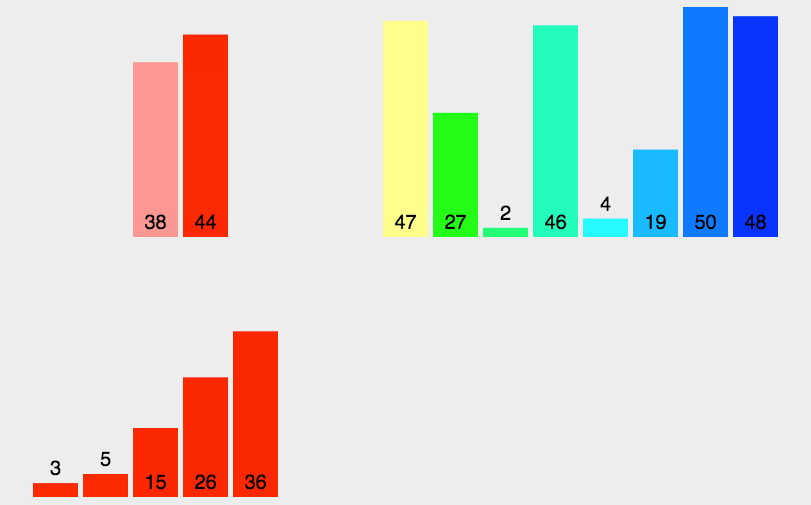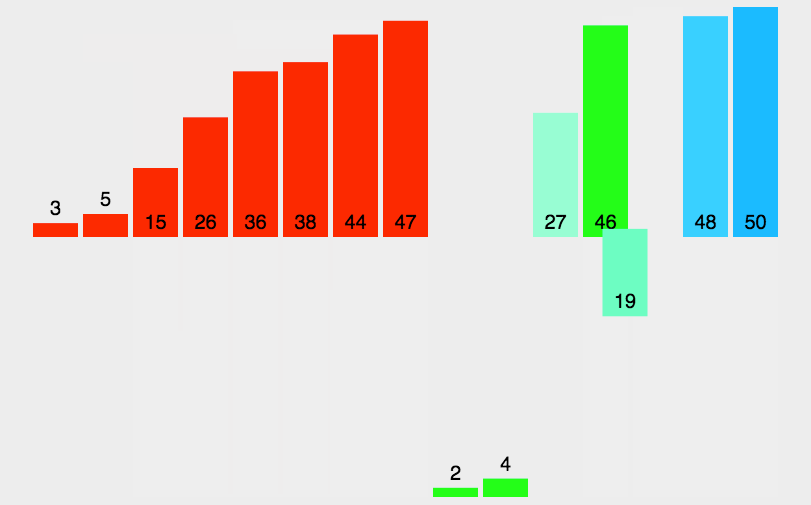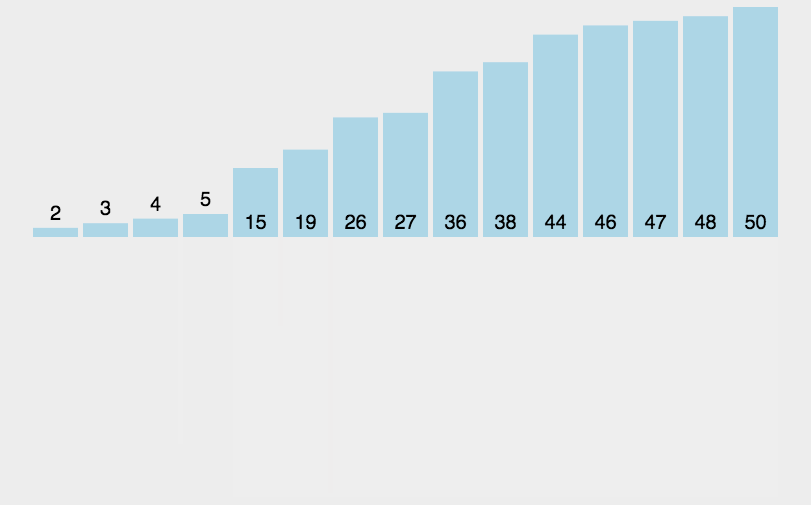
归并排序是建立在归并操作上的一种有效的排序算法。该算法是采用分治法(Divide and Conquer)的一个非常典型的应用。将已有序的子序列合并,得到完全有序的序列;即先使每个子序列有序,再使子序列段间有序。若将两个有序表合并成一个有序表,称为2-路归并。
算法描述
- 把长度为n的输入序列分成两个长度为n/2的子序列;
- 对这两个子序列分别采用归并排序;
- 将两个排序好的子序列合并成一个最终的排序序列。
动图演示
代码实现
#include <iostream>
using namespace std;
void mergeSort(int *a, int start, int end);
void merge(int *a, int start, int mid, int end);
int main() {
    int a[] = {10, 9, 8, 7, 6, 5, 4, 3, 2, 1};
    int len = (int)sizeof(a) / sizeof(*a);
    mergeSort(a, 0, len);

    for(int i = 0; i < len; i++) {
        cout << a[i] << ' ';
    }

    return 0;
}
void mergeSort(int *a, int start, int end) {
    if(a == NULL || start >= end) {
        return ;
    }

    int mid = (start + end) / 2;
    mergeSort(a, start, mid);
    mergeSort(a, mid + 1, end);
    merge(a, start, mid, end);
}
void merge(int *a, int start, int mid, int end) {
    int *temp = (int *)malloc(sizeof(int) * (end - start + 1));
    int i = start;
    int j = mid + 1;
    int k = 0;

    while(i <= mid && j <= end) {
        if(a[i] <= a[j]) {
            temp[k++] = a[i++];
        } else {
            temp[k++] = a[j++];
        }
    }

    while(i <= mid) {
        temp[k++] = a[i++];
    }

    while(j <= end) {
        temp[k++] = a[j++];
    }

    for(int i = 0; i < k; i++) {
        a[start + i] = temp[i];
    }

    free(temp);
    temp = NULL;
}
快速排序(Quick Sort)
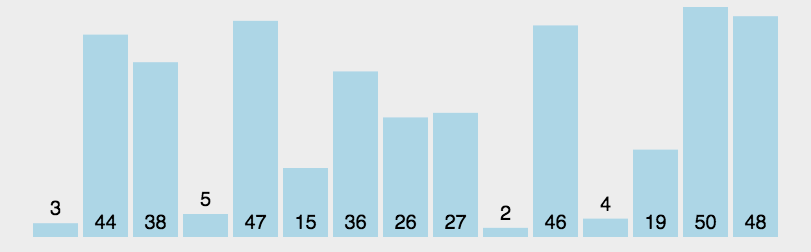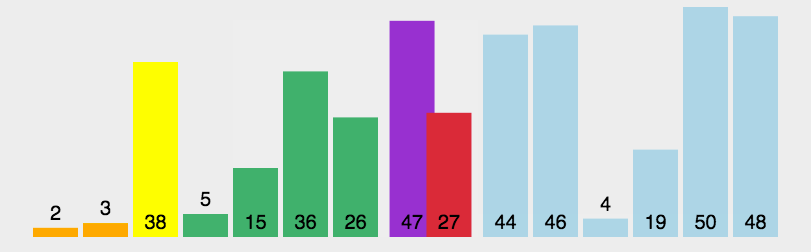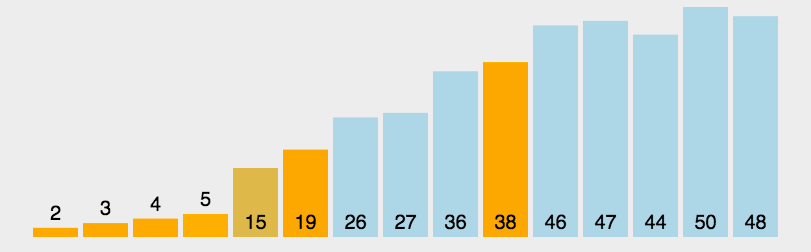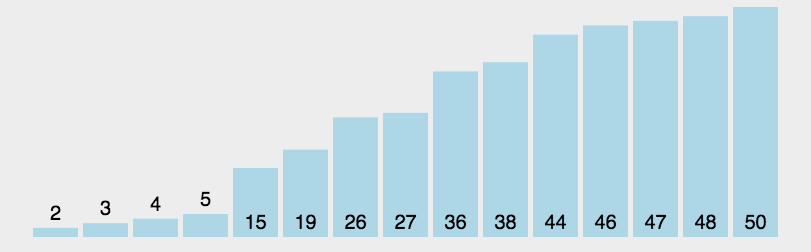
快速排序的基本思想:通过一趟排序将待排记录分隔成独立的两部分,其中一部分记录的关键字均比另一部分的关键字小,则可分别对这两部分记录继续进行排序,以达到整个序列有序。
算法描述
快速排序使用分治法来把一个串(list)分为两个子串(sub-lists)。具体算法描述如下:
- 从数列中挑出一个元素,称为 “基准”(pivot);
- 重新排序数列,所有元素比基准值小的摆放在基准前面,所有元素比基准值大的摆在基准的后面(相同的数可以到任一边)。在这个分区退出之后,该基准就处于数列的中间位置。这个称为分区(partition)操作;
- 递归地(recursive)把小于基准值元素的子数列和大于基准值元素的子数列排序。
动图演示
代码实现
#include <iostream>
using namespace std;
void quickSort(int *a, int begin, int end);
int main() {
    int a[] = {10, 9, 8, 7, 6, 5, 4, 3, 2, 1};
    int len = (int)sizeof(a) / sizeof(*a);
    quickSort(a, 0, len);

    for(int i = 0; i < len; i++) {
        cout << a[i] << ' ';
    }

    return 0;
}
void quickSort(int *a, int begin, int end) {
    if(begin >= end) {
        return;
    }

    int left = begin ;
    int right = end;
    int key = begin;

    while(left < right) {
        while(left < right && a[key] <= a[right]) {
            right--;
        }

        while(left < right && a[key] >= a[left]) {
            left++;
        }

        swap(a[left], a[right]);
    }

    swap(a[key], a[right]);
    key = right;
    quickSort(a, begin, key);
    quickSort(a, key + 1, end);
}
堆排序(Heap Sort)
堆排序(Heapsort)是指利用堆这种数据结构所设计的一种排序算法。堆积是一个近似完全二叉树的结构,并同时满足堆积的性质:即子结点的键值或索引总是小于(或者大于)它的父节点。
大顶堆:每个节点的值都大于或等于其子节点的值,在堆排序算法中用于升序排列;
小顶堆:每个节点的值都小于或等于其子节点的值,在堆排序算法中用于降序排列;
堆的性质
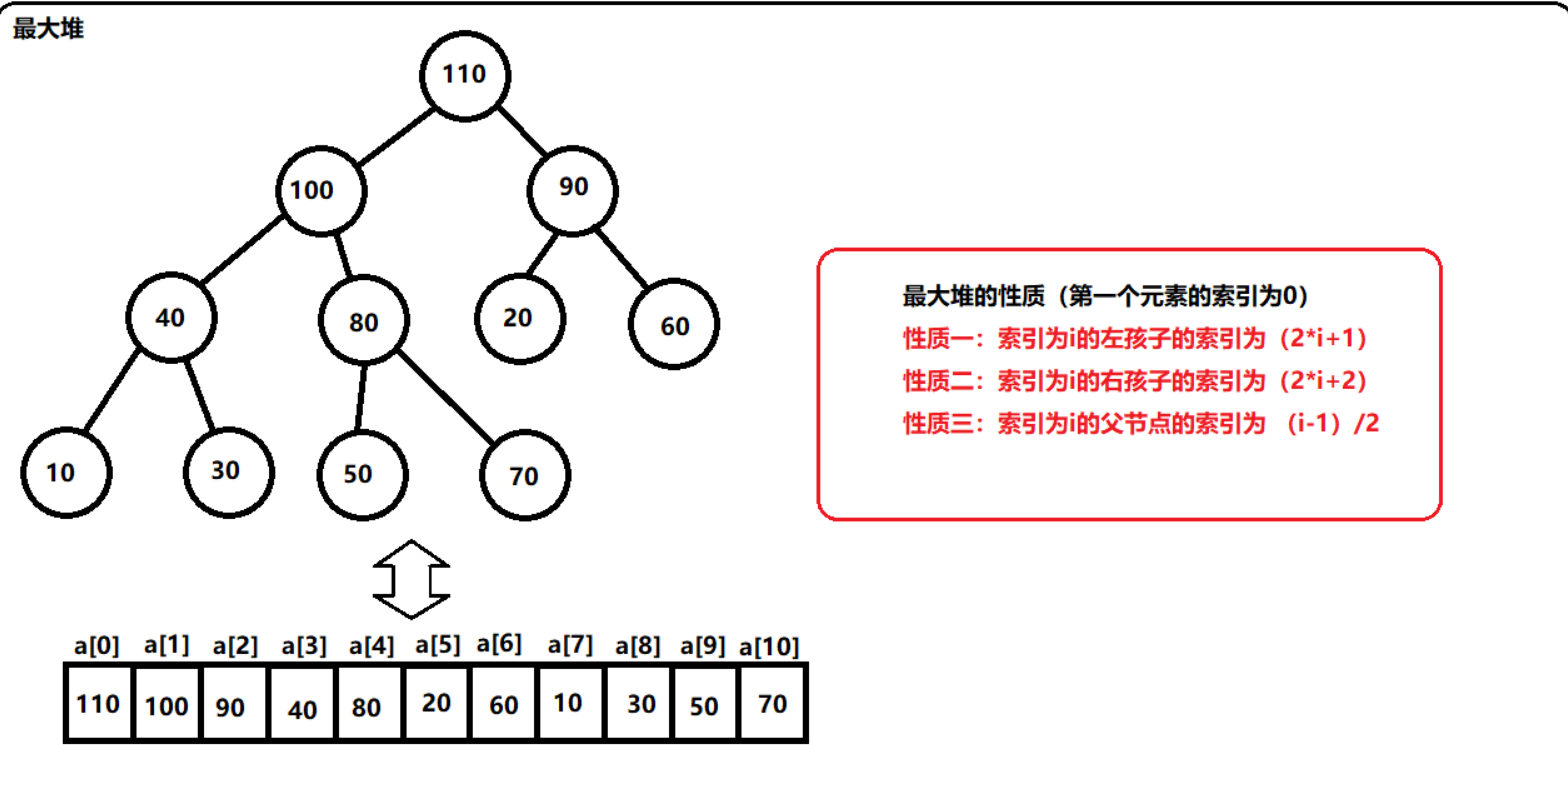
例如,对于最大堆{110,100,90,40,80,20,60,10,30,50,70} 而言:索引为0的左孩子的索引是1;索引为0的右孩子的索引是2;索引为8的父节点是3.
算法描述
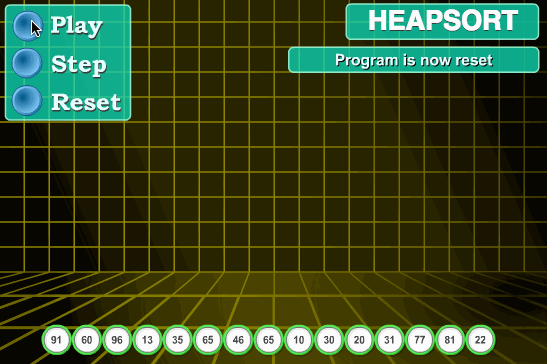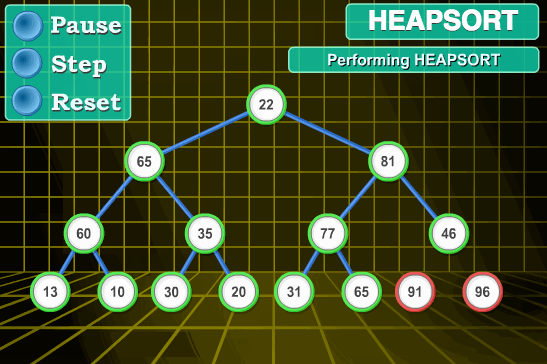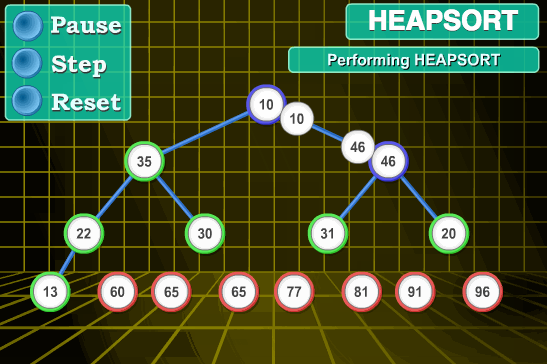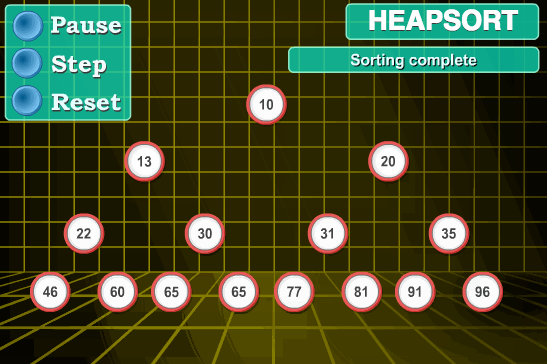
- 将初始待排序关键字序列(R1,R2….Rn)构建成大顶堆,此堆为初始的无序区;
- 将堆顶元素R[1]与最后一个元素R[n]交换,此时得到新的无序区(R1,R2,……Rn-1)和新的有序区(Rn),且满足R[1,2…n-1]<=R[n];
- 由于交换后新的堆顶R[1]可能违反堆的性质,因此需要对当前无序区(R1,R2,……Rn-1)调整为新堆,然后再次将R[1]与无序区最后一个元素交换,得到新的无序区(R1,R2….Rn-2)和新的有序区(Rn-1,Rn)。不断重复此过程直到有序区的元素个数为n-1,则整个排序过程完成。
动图演示
代码实现
#include <iostream>
using namespace std;
void heapify(int *a, int n, int c);
void heapSort(int *a, int n);
int main() {
    int a[] = {10, 9, 8, 7, 6, 5, 4, 3, 2, 1};
    int len = (int)sizeof(a) / sizeof(*a);
    heapSort(a,len);
    for(int i = 0; i < len; i++) {
        cout << a[i] << ' ';
    }

    return 0;
}
void heapify(int *a, int n, int c) {
    if(c >= n) {
        return;
    }

    int large = c;
    int left_son = c * 2 + 1;
    int right_son = c * 2 + 2;

    if(left_son < n && a[large] < a[left_son]) {
        large = left_son;
    }

    if(right_son < n && a[large] < a[right_son]) {
        large = right_son;
    }

    if(large != c) {
        swap(a[c], a[large]);
        heapify(a, n, large);
    }
}
void heapSort(int *a, int n) {
    int lastnode = n - 1;
    int parent = (lastnode-1)/2;
    for(int i=parent;i>=0;i--){
        heapify(a,n,i);
    }
    for(int i=n-1;i>=0;i--){//sort
        swap(a[i],a[0]);
        heapify(a,i,0);
    }
}
计数排序(Counting Sort)
计数排序不是基于比较的排序算法,其核心在于将输入的数据值转化为键存储在额外开辟的数组空间中。 作为一种线性时间复杂度的排序,计数排序要求输入的数据必须是有确定范围的整数。
算法描述
- 找出待排序的数组中最大和最小的元素;
- 统计数组中每个值为i的元素出现的次数,存入数组C的第i项;
- 对所有的计数累加(从C中的第一个元素开始,每一项和前一项相加);
- 反向填充目标数组:将每个元素i放在新数组的第C(i)项,每放一个元素就将C(i)减去1。
动图演示
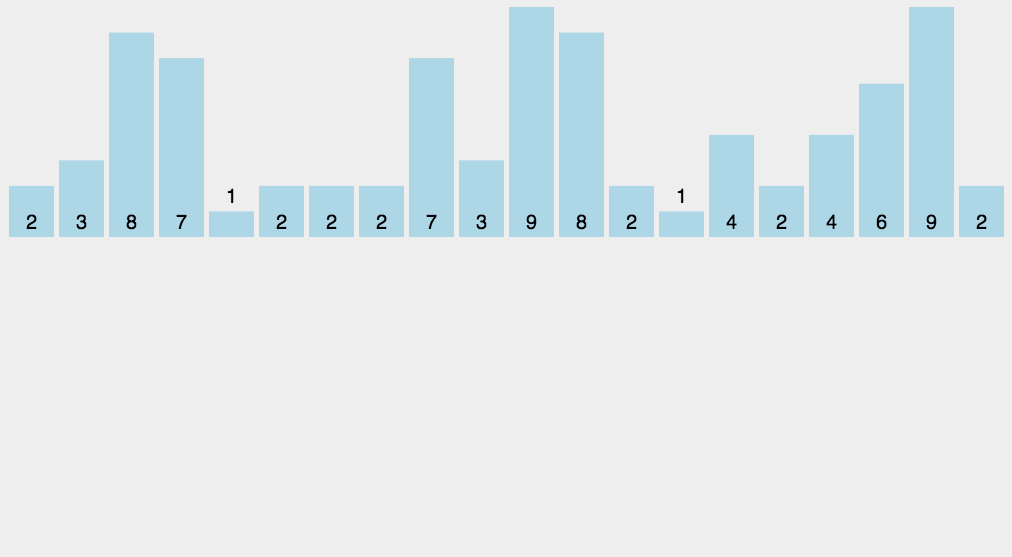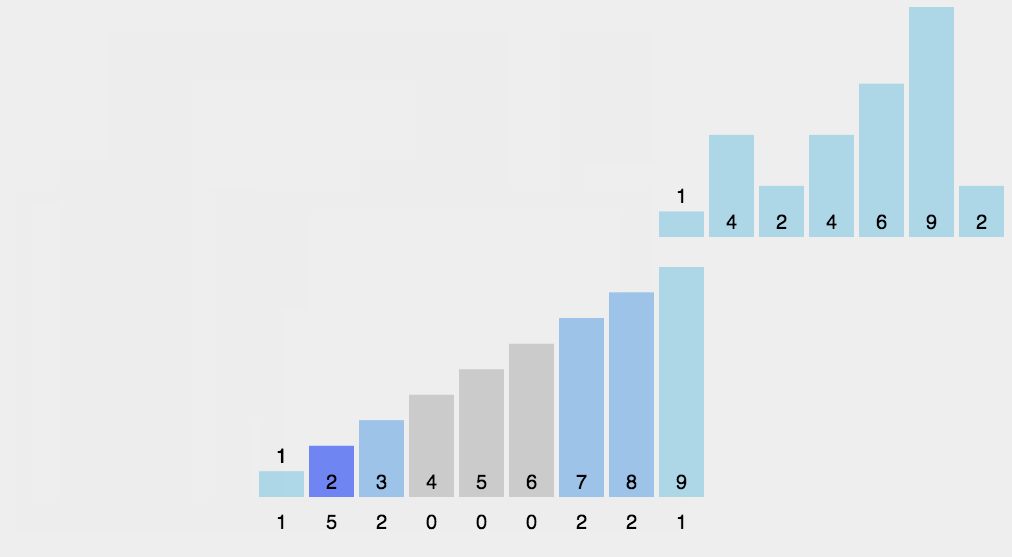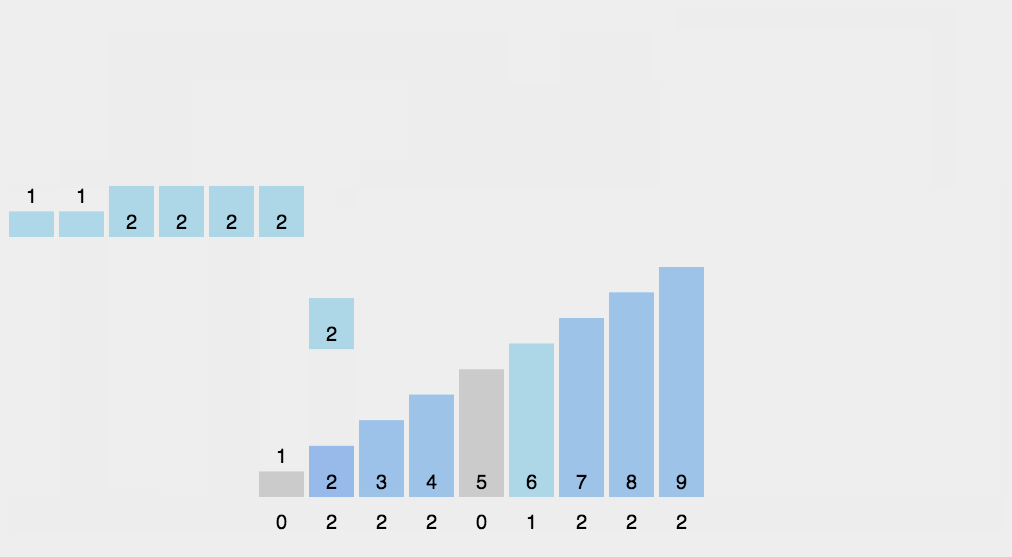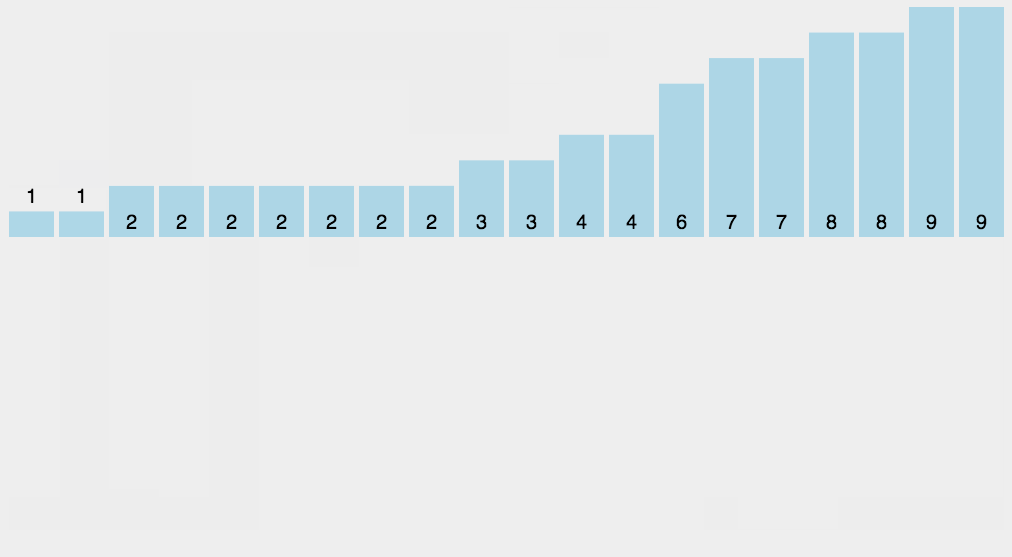
代码实现
#include <iostream>
#include <string.h>
using namespace std;
void countSort(int *a, int n);
int main() {
    int a[] = {10, 9, 8, 7, 6, 5, 4, 3, 2, 1};
    int len = (int)sizeof(a) / sizeof(*a);
    countSort(a, len);

    for(int i = 0; i < len; i++) {
        cout << a[i] << ' ';
    }

    return 0;
}
void countSort(int *a, int n) {
    int max = a[0];
    int min = a[0];

    for(int i = 1; i < n; i++) {
        if(a[i] < min) {
            min = a[i];
        }

        if(a[i] > max) {
            max = a[i];
        }
    }

    int range = max - min + 1;
    int *countArray = (int *)malloc(sizeof(int) * range);
    memset(countArray, 0, sizeof(int)*range);

    for(int i = 0; i < n; i++) {
        countArray[a[i] - min]++;
    }

    for(int i = 0; i < range; i++) {
    }

    int j = 0;

    for(int i = 0; i < range; i++) {
        while(countArray[i]--) {
            a[j++] = i + min;
        }
    }

    free(countArray);
}
桶排序(Bucket Sort)
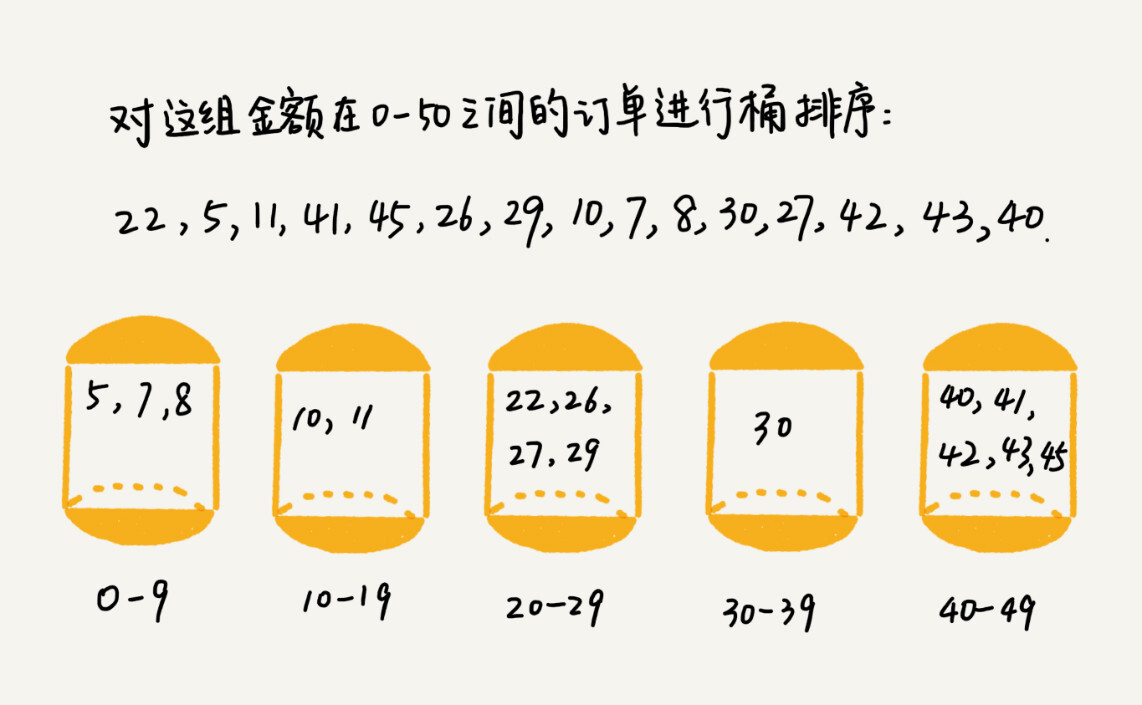
桶排序是计数排序的升级版。它利用了函数的映射关系,高效与否的关键就在于这个映射函数的确定。桶排序 (Bucket sort)的工作的原理:假设输入数据服从均匀分布,将数据分到有限数量的桶里,每个桶再分别排序(有可能再使用别的排序算法或是以递归方式继续使用桶排序进行排)。核心思想是将要排序的数据分到几个有序的桶里,每个桶里的数据再单独进行排序。桶内排完序之后,再把每个桶里的数据按照顺序依次取出,组成的序列就是有序的了。
算法描述
- 设置一个定量的数组当作空桶;
- 遍历输入数据,并且把数据一个一个放到对应的桶里去;
- 对每个不是空的桶进行排序;
- 从不是空的桶里把排好序的数据拼接起来。
图片演示
代码实现
#include <iostream>
#include <string.h>
#include<stdio.h>
#include<stdlib.h>
#include<math.h>
#include<assert.h>
using namespace std;
struct barrel {
    int node[10];
    int count;/* the num of node */
};
int partition(int a[], int left, int right) {
    int i = left;
    int j = right;
    int key = a[left];

    while(i < j) {
        while((i < j) && (a[j] >= key)) {
            j--;
        }

        if(i < j) {
            a[i] = a[j];
        }

        while((i < j) && a[i] <= key) {
            i++;
        }

        if(i < j) {
            a[j] = a[i];
        }
    }

    a[i] = key;
    return i;
}
void quick_sort(int a[], int left, int right) {
    int q = 0;

    /*递归终止条件*/
    if(left >= right) {
        return;
    }

    q = partition(a, left, right);
    quick_sort(a, left, (q - 1));
    quick_sort(a, (q + 1), right);
    return;
}
void bucket_sort(int data[], int size);
int main() {
    int a[] = {10, 9, 8, 7, 6, 5, 4, 3, 2, 1};
    int len = (int)sizeof(a) / sizeof(*a);
    bucket_sort(a, len);

    for(int i = 0; i < len; i++) {
        cout << a[i] << ' ';
    }

    return 0;
}
void bucket_sort(int data[], int size) {
    int max, min, num, pos;
    int i, j, k;
    struct barrel *pBarrel;
    max = min = data[0];

    for(i = 1; i < size; i++) {
        if(data[i] > max) {
            max = data[i];
        } else if(data[i] < min) {
            min = data[i];
        }
    }

    num = (max - min + 1) / 10 + 1;
    pBarrel = (struct barrel *)malloc(sizeof(struct barrel) * num);
    memset(pBarrel, 0, sizeof(struct barrel) * num);

    /* put data[i] into barrel which it belong to */
    for(i = 0; i < size; i++) {
        k = (data[i] - min + 1) / 10;/* calculate the index of data[i] in barrel */
        (pBarrel + k)->node[(pBarrel + k)->count] = data[i];
        (pBarrel + k)->count++;
    }

    pos = 0;

    for(i = 0; i < num; i++) {
        if((pBarrel + i)->count != 0) {
            quick_sort((pBarrel + i)->node, 0, ((pBarrel + i)->count) - 1); /* sort node in every barrel */

            for(j = 0; j < (pBarrel + i)->count; j++) {
                data[pos++] = (pBarrel + i)->node[j];
            }
        }
    }

    free(pBarrel);
}
基数排序(Radix Sort)
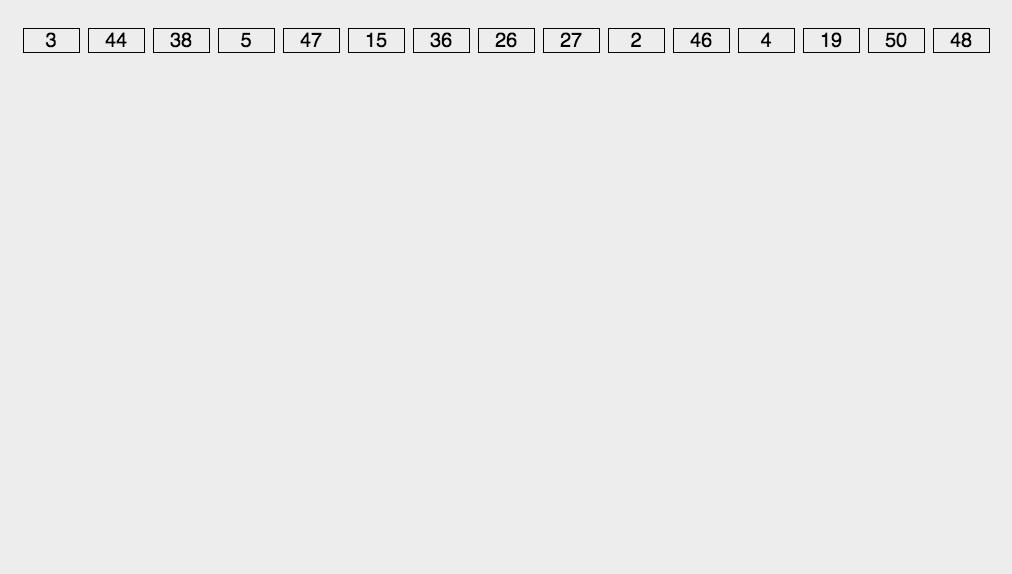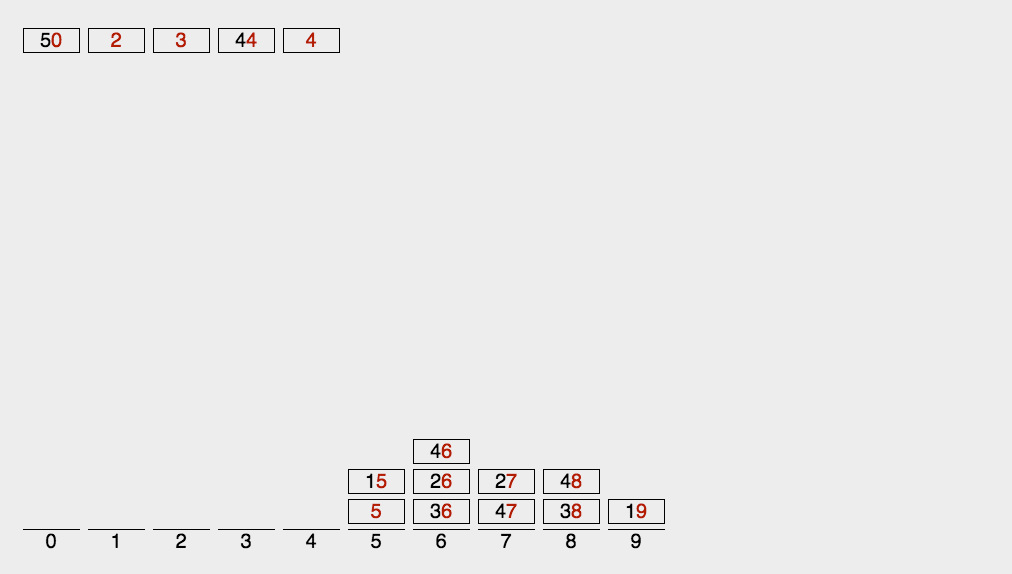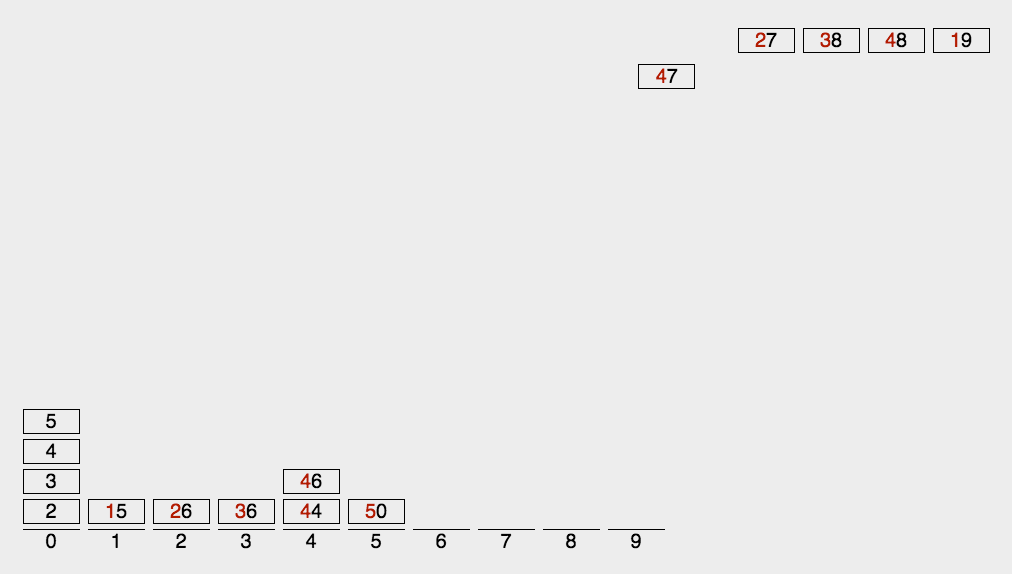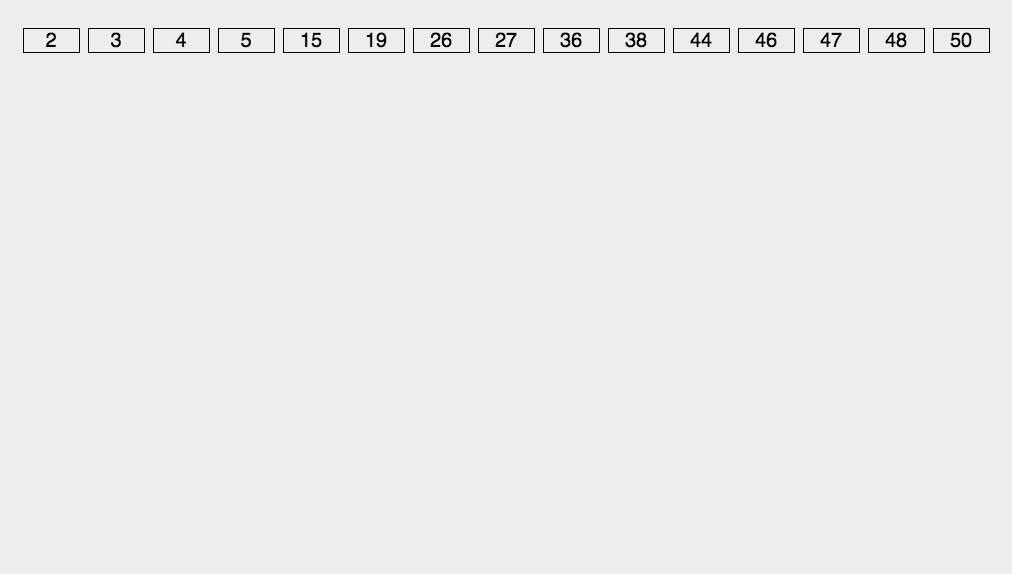
基数排序是按照低位先排序,然后收集;再按照高位排序,然后再收集;依次类推,直到最高位。有时候有些属性是有优先级顺序的,先按低优先级排序,再按高优先级排序。最后的次序就是高优先级高的在前,高优先级相同的低优先级高的在前。
算法描述
- 取得数组中的最大数,并取得位数;
- arr为原始数组,从最低位开始取每个位组成radix数组;
- 对radix进行计数排序(利用计数排序适用于小范围数的特点);
动图演示
代码实现
#include <iostream>
#include <string.h>
using namespace std;
int arrmax(int *arr, int len);
void _radixsort(int *arr, int len, int exp);
void radixSort(int *arr, int len);
int main() {
    int a[] = {10, 9, 8, 7, 6, 5, 4, 3, 2, 1};
    int len = (int)sizeof(a) / sizeof(*a);
    radixSort(a, len);

    for(int i = 0; i < len; i++) {
        cout << a[i] << ' ';
    }

    return 0;
}
int arrmax(int *arr, int len) {
    int ii, imax;
    imax = arr[0];

    for(ii = 1; ii < len; ii++)
        if(arr[ii] > imax) imax = arr[ii];

    return imax;
}
void _radixsort(int *arr, int len, int exp) {
    int ii;
    int result[len];
    int buckets[10] = {0};

    for(ii = 0; ii < len; ii++)
        buckets[(arr[ii] / exp) % 10]++;

    for(ii = 1; ii < 10; ii++)
        buckets[ii] = buckets[ii] + buckets[ii - 1];

    for(ii = len - 1; ii >= 0; ii--) {
        int iexp = (arr[ii] / exp) % 10;
        result[buckets[iexp] - 1] = arr[ii];
        buckets[iexp]--;
    }

    memcpy(arr, result, len * sizeof(int));
}
void radixSort(int *arr, int len) {
    int imax = arrmax(arr, len);
    int iexp;

    for(iexp = 1; imax / iexp > 0; iexp = iexp * 10) {
        _radixsort(arr, len, iexp);
    }
}
21年的咕咕终于在这一刻还清了