pytorch的NN module类——MINIST 数据集

内容纲要
import torch
from torchvision import datasets, transforms
from torch import nn, optim
import torch.nn.functional as F

# 检查MPS是否可用并设置设备
device = torch.device("mps" if torch.backends.mps.is_available() else "cpu")
print(f"Using {device} device")

# 数据加载与转换
transform = transforms.Compose([transforms.ToTensor(),
                                transforms.Normalize((0.5,), (0.5,))])

trainset = datasets.MNIST('~/.pytorch/MNIST_data/', download=True, train=True, transform=transform)
trainloader = torch.utils.data.DataLoader(trainset, batch_size=64, shuffle=True)

testset = datasets.MNIST('~/.pytorch/MNIST_data/', download=True, train=False, transform=transform)
testloader = torch.utils.data.DataLoader(testset, batch_size=64, shuffle=True)

# 定义模型
class Network(nn.Module):
    def __init__(self):
        super(Network, self).__init__()
        self.fc1 = nn.Linear(784, 128)
        self.fc2 = nn.Linear(128, 64)
        self.fc3 = nn.Linear(64, 10)

    def forward(self, x):
        x = x.view(x.shape[0], -1)
        x = F.relu(self.fc1(x))
        x = F.relu(self.fc2(x))
        x = F.log_softmax(self.fc3(x), dim=1)
        return x

model = Network().to(device)

# 加载模型状态
model.load_state_dict(torch.load('/Users/davidlee/Downloads/model.pth'))

# 训练模型
criterion = nn.NLLLoss()
optimizer = optim.Adam(model.parameters(), lr=0.003)

epochs = 5
for e in range(epochs):
    running_loss = 0
    for images, labels in trainloader:
        images, labels = images.to(device), labels.to(device)

        optimizer.zero_grad()
        output = model(images)
        loss = criterion(output, labels)
        loss.backward()
        optimizer.step()

        running_loss += loss.item()
    else:
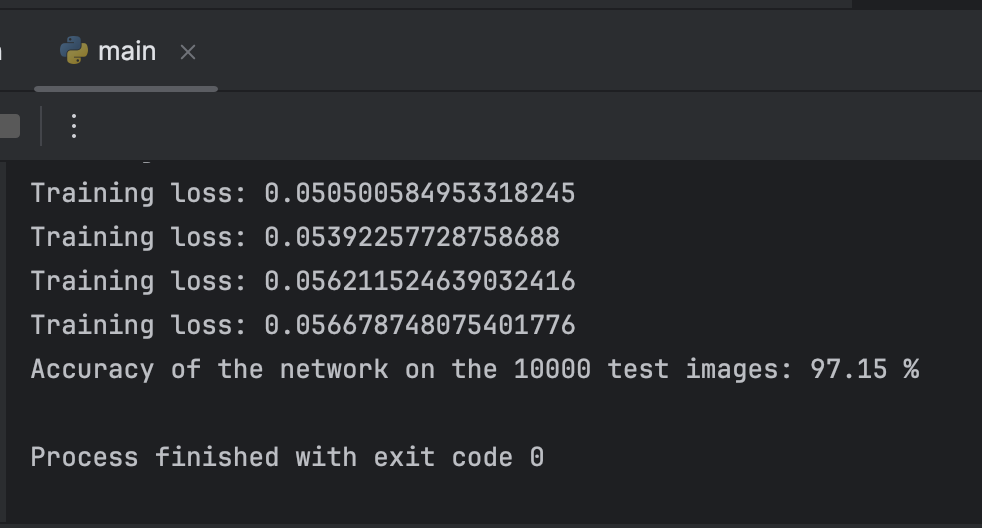
        print(f"Training loss: {running_loss / len(trainloader)}")

# 测试模型
correct = 0
total = 0
with torch.no_grad():
    for images, labels in testloader:
        images, labels = images.to(device), labels.to(device)
        outputs = model(images)
        _, predicted = torch.max(outputs.data, 1)
        total += labels.size(0)
        correct += (predicted == labels).sum().item()

print(f'Accuracy of the network on the 10000 test images: {100 * correct / total} %')
# 保存模型状态字典
torch.save(model.state_dict(), '/Users/davidlee/Downloads/model.pth')
这段代码是一个PyTorch脚本,用于在MNIST数据集上训练、测试一个简单的神经网络模型,并保存模型。
import torch- 导入PyTorch库,用于构建和训练神经网络。
from torchvision import datasets, transforms- 从
torchvision库导入datasets和transforms模块。torchvision是处理图像数据的库,datasets用于下载/加载数据集,transforms用于预处理图像数据。
from torch import nn, optim- 从
torch中导入nn和optim模块。nn模块包含构建神经网络的类和函数,optim模块提供了优化算法,如SGD、Adam等。
import torch.nn.functional as F- 导入
torch.nn.functional,这是一个包含常用函数如激活函数、损失函数的模块,通常以F别名导入。
device = torch.device("mps" if torch.backends.mps.is_available() else "cpu")- 检查MPS(苹果的Metal Performance Shaders)是否可用作为后端,如果可用,则使用MPS;否则,使用CPU。这是为了实现在支持的Mac硬件上的加速。
print(f"Using {device} device")- 打印出使用的设备(MPS或CPU)。
transform = transforms.Compose([transforms.ToTensor(), transforms.Normalize((0.5,), (0.5,))])- 定义图像数据的预处理步骤:将图像转换为PyTorch张量,并对图像进行标准化。
trainset = datasets.MNIST('~/.pytorch/MNIST_data/', download=True, train=True, transform=transform)- 下载MNIST训练数据集,应用预定义的转换,并将其存储在指定路径。
trainloader = torch.utils.data.DataLoader(trainset, batch_size=64, shuffle=True)- 使用
DataLoader创建一个训练数据的迭代器,设置批量大小为64,并打乱数据。
testset = datasets.MNIST('~/.pytorch/MNIST_data/', download=True, train=False, transform=transform)- 下载MNIST测试数据集,应用相同的转换。
testloader = torch.utils.data.DataLoader(testset, batch_size=64, shuffle=True)- 创建一个测试数据的迭代器,设置批量大小和打乱数据。
class Network(nn.Module):
    def __init__(self):
        super(Network, self).__init__()
        self.fc1 = nn.Linear(784, 128)
        self.fc2 = nn.Linear(128, 64)
self.fc3 = nn.Linear(64, 10)- 定义一个继承自
nn.Module的神经网络类Network。模型包括三个全连接层。
    def forward(self, x):
        x = x.view(x.shape[0], -1)
        x = F.relu(self.fc1(x))
        x = F.relu(self.fc2(x))
        x = F.log_softmax(self.fc3(x), dim=1)
return x- 定义模型的前向传播路径:输入
x被展平,然后依次通过三个全连接层,其中前两层使用ReLU激活函数,最后一层使用log softmax输出概率分布。
model = Network().to(device)- 实例化
Network模型,并将其移动到之前选择的设备(MPS或CPU)上。
model.load_state_dict(torch.load('/Users/davidlee/Downloads/model.pth'))- 加载之前保存的模型状态字典。这一行应在模型定义之后,训练之前执行,但在这个脚本中应该是为了展示如何加载模型,实际使用时可能需要调整。
criterion = nn.NLLLoss()- 定义损失函数为负对数似然损失,适合多分类问题。
optimizer = optim.Adam(model.parameters(), lr=0.003)- 定义优化器为Adam,学习率设置为0.003,优化器用于更新模型的参数。
epochs = 5- 设置训练的轮数为5。
for e in range(epochs):
    running_loss = 0
for images, labels in trainloader:- 开始训练循环,每个epoch遍历一次训练数据集。
images, labels = images.to(device), labels.to(device)- 将图像和标签移动到之前选择的设备上(MPS或CPU)。
optimizer.zero_grad()- 在每次梯度计算之前,清零累积的梯度,避免影响下一批次的梯度计算。
output = model(images)- 通过模型前向传播计算预测输出。
loss = criterion(output, labels)- 计算预测输出和真实标签之间的损失。
loss.backward()- 反向传播:根据损失计算梯度。
optimizer.step()- 使用优化器更新模型参数。
running_loss += loss.item()- 累加每批次的损失,用于计算平均损失。
    else:
print(f"Training loss: {running_loss / len(trainloader)}")- 每个epoch结束后,打印平均损失。
correct = 0
total = 0- 初始化正确预测的数量和总数量,用于计算准确率。
with torch.no_grad():- 在测试模型时,不计算梯度,以节省计算资源和内存。
for images, labels in testloader:- 遍历测试数据集。
images, labels = images.to(device), labels.to(device)- 将图像和标签移动到设备上。
outputs = model(images)- 计算测试图像的模型输出。
_, predicted = torch.max(outputs.data, 1)- 从输出中获取最大概率的索引,即预测的类别。
total += labels.size(0)- 更新处理的总图像数量。
correct += (predicted == labels).sum().item()- 更新正确预测的数量。
print(f'Accuracy of the network on the 10000 test images: {100 * correct / total} %')- 打印模型在测试集上的准确率。
torch.save(model.state_dict(), '/Users/davidlee/Downloads/model.pth')- 将训练后的模型状态字典保存到文件,以便将来使用或继续训练。